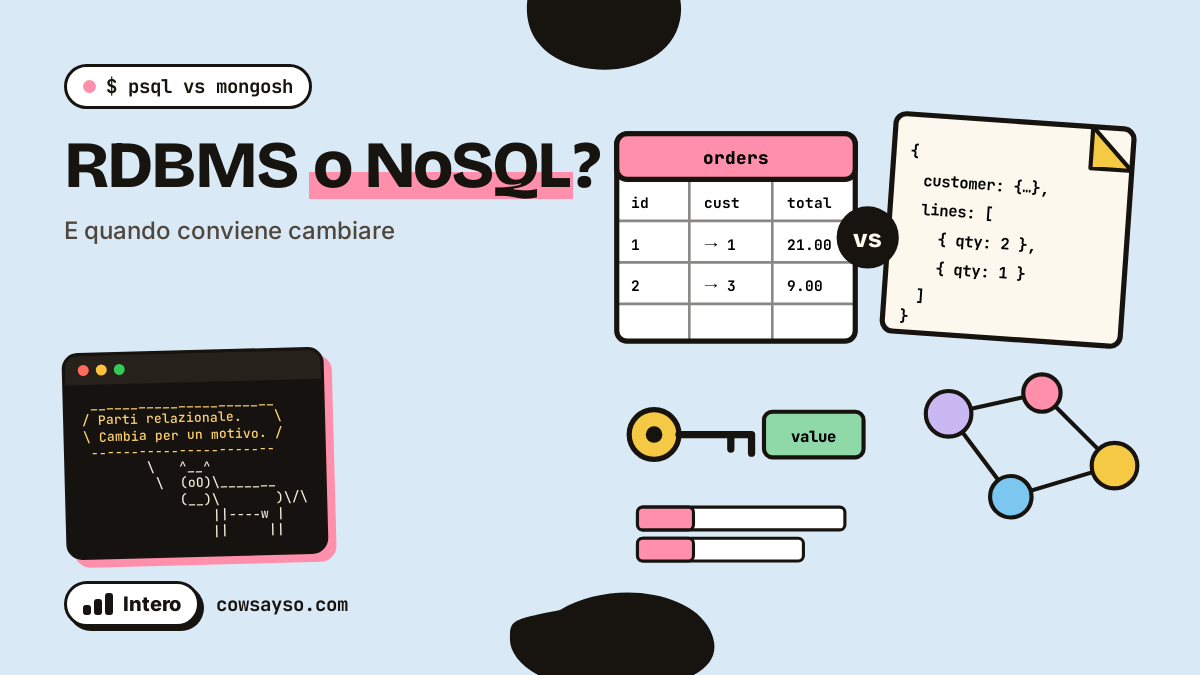
Ogni tanto, in ufficio, qualcuno fa la domanda con la sicurezza di chi ha appena visto un talk a una conferenza: «Usiamo un database relazionale o un NoSQL?»
Da una parte i database relazionali (RDBMS), quelli con cui si parla in SQL: PostgreSQL, MySQL e compagnia. Dall’altra quelli non relazionali, che vanno sotto il nome di NoSQL: MongoDB, Redis, Cassandra, Neo4j e molti altri. Vediamo cosa li separa davvero, e quando conviene passare dall’altra parte.
Questo è un articolo intero: c’è codice, ci sono sigle, c’è un teorema. Tutti gli esempi sono stati eseguiti davvero, su PostgreSQL 16, MongoDB 8.3, Redis 7.4, Cassandra 5.0 e Neo4j 5.26, e gli output sono quelli reali.
Un po’ di storia
Nel 1970 Edgar F. Codd, al laboratorio di ricerca IBM di San Jose, pubblicò «A Relational Model of Data for Large Shared Data Banks». La sua idea era che chi usa i dati non dovesse sapere come sono organizzati fisicamente dentro la macchina: i dati vivono in relazioni, tabelle fatte di righe e colonne, e si interrogano con un linguaggio di alto livello. Funzionò così bene da valergli il premio Turing nel 1981, e regge ancora buona parte del mondo.
La parola «NoSQL» ha una storia più buffa. Nel 1998 Carlo Strozzi la usò come nome del suo database, che era, guarda un po’, relazionale: semplicemente non usava SQL. Nel 2009 Johan Oskarsson, allora a Last.fm, riprese il termine per un incontro su database open source, distribuiti e non relazionali, e quella volta il nome restò. Oggi di solito si legge come «not only SQL», non solo SQL.
Stesso dato, due modelli
Prendiamo una cosa concreta: un ordine. Un cliente, dei prodotti, quantità, prezzi. In un database relazionale lo si divide in tabelle, ognuna con la sua responsabilità, collegate da chiavi:
CREATE TABLE customers (
  id    serial PRIMARY KEY,
  name  text NOT NULL,
  email text UNIQUE NOT NULL
);
CREATE TABLE products (
  id    serial PRIMARY KEY,
  name  text NOT NULL,
  price numeric(10,2) NOT NULL,
  stock int NOT NULL CHECK (stock >= 0)
);
CREATE TABLE orders (
  id          serial PRIMARY KEY,
  customer_id int NOT NULL REFERENCES customers(id),
  created_at  timestamptz NOT NULL DEFAULT now()
);
CREATE TABLE order_lines (
  order_id   int REFERENCES orders(id),
  product_id int REFERENCES products(id),
  qty        int NOT NULL CHECK (qty > 0),
  unit_price numeric(10,2) NOT NULL,
  PRIMARY KEY (order_id, product_id)
);
È il database stesso a garantire le regole: un ordine non può puntare a un cliente che non esiste, una quantità non può essere zero, le scorte non possono andare sotto zero. Per vedere un ordine con il suo totale, si rimettono insieme i pezzi con una JOIN:
SELECT o.id, c.name, sum(l.qty * l.unit_price) AS total
FROM orders o
JOIN customers c   ON c.id = o.customer_id
JOIN order_lines l ON l.order_id = o.id
GROUP BY o.id, c.name;

 id | name | total
----+------+-------
  1 | Pina | 21.00
In un database a documenti come MongoDB, lo stesso ordine è un unico documento, fatto come lo mostreresti a schermo:
db.orders.insertOne({
  _id: 1,
  customer: { name: "Pina", email: "pina@example.com" },
  lines: [
    { product: "Hay bale",    qty: 2, unit_price: 4.5 },
    { product: "Milk bucket", qty: 1, unit_price: 12 }
  ],
  created_at: new Date("2025-10-07T09:00:00Z")
})
db.orders.aggregate([
{ $project: {
customer: "$customer.name",
total: { $sum: { $map: { input: "$lines", as: "l",
in: { $multiply: ["$$l.qty", "$$l.unit_price"] } } } }
} }
])
[ { _id: 1, customer: 'Pina', total: 21 } ]Una lettura, c’è tutto, nessuna JOIN. È la forza del modello a documenti. Il conto arriva il giorno in cui Pina cambia cognome: il suo nome è copiato dentro ogni ordine che abbia mai fatto, quindi vanno aggiornati tutti:
db.orders.updateMany(
  { "customer.email": "pina@example.com" },
  { $set: { "customer.name": "Pina Bianchi" } }
)
Nel modello relazionale cambieresti una riga in customers. In quello a documenti cambi ogni copia, e se ne dimentichi una nessuno te lo dirà.
Le quattro famiglie NoSQL
«NoSQL» non è una cosa sola: sono quattro famiglie molto diverse, ognuna pensata per un modo diverso di leggere i dati.
1. Documenti (MongoDB)
L’avete appena visto: documenti simili a JSON, annidati, letti e scritti interi. Va bene quando i dati hanno un’«unità» naturale (un ordine, una scheda prodotto, un profilo utente) che si legge quasi sempre tutta insieme.
2. Chiave–valore (Redis)
Il modello più semplice che esista: una chiave, un valore. Niente ricerche sul contenuto: conosci la chiave, ottieni il valore, velocissimo. Redis tiene i dati in memoria e aggiunge extra utili, come la scadenza automatica e i contatori atomici:
> SET session:42 "{\"user\":\"pina\"}" EX 1800
OK
> GET session:42
{"user":"pina"}
> TTL session:42
1800
> INCR views:home
1
> INCR views:home
2
Sessioni che scadono da sole dopo 30 minuti, contatori di visite, cache: è il terreno di casa dei chiave–valore.
3. Colonne larghe (Cassandra)
Cassandra è nata in Facebook, dove Avinash Lakshman e Prashant Malik la svilupparono per la ricerca nella posta in arrivo, ed è stata rilasciata come open source nel 2008. Unisce idee del Dynamo di Amazon (come distribuire e replicare i dati su tante macchine) e del Bigtable di Google (come conservarli). Si scrive ancora qualcosa che somiglia a SQL, ma le regole sono diverse. Ecco le mungiture di ogni mucca, partizionate per mucca e per giorno:
CREATE TABLE farm.milk_readings (
  cow_id text,
  day    date,
  ts     timestamp,
  litres double,
  PRIMARY KEY ((cow_id, day), ts)
) WITH CLUSTERING ORDER BY (ts DESC);

CONSISTENCY QUORUM;
SELECT ts, litres FROM farm.milk_readings
WHERE cow_id = 'ercolina' AND day = '2025-10-07';

 ts                              | litres
---------------------------------+--------
 2025-10-07 18:00:00.000000+0000 |   12.9
 2025-10-07 06:00:00.000000+0000 |   14.2
Ora proviamo a fare una domanda per cui la tabella non è stata pensata:
SELECT * FROM farm.milk_readings WHERE litres > 13;

InvalidRequest: Error from server: code=2200 [Invalid query]
message="Cannot execute this query as it might involve data filtering and thus
may have unpredictable performance. If you want to execute this query despite
the performance unpredictability, use ALLOW FILTERING"
Cassandra rifiuta, con garbo. È la lezione centrale: in un database relazionale progettate i dati e poi fate le domande che volete; in Cassandra progettate le tabelle attorno alle domande che farete. In cambio avete scritture distribuite su tanti nodi e dati replicati tra data center.
4. Grafi (Neo4j)
Quando la parte interessante sono le relazioni stesse, un database a grafo memorizza direttamente nodi e collegamenti. Chi sono gli amici delle amiche di Ercolina?
CREATE (e:Cow {name: 'Ercolina'}), (c:Cow {name: 'Carolina'}),
       (b:Cow {name: 'Bianca'}),   (r:Cow {name: 'Rosina'})
CREATE (e)-[:FRIEND_OF]->(c), (c)-[:FRIEND_OF]->(b), (c)-[:FRIEND_OF]->(r);

MATCH (:Cow {name: 'Ercolina'})-[:FRIEND_OF*2]->(fof:Cow)
RETURN fof.name AS friend_of_a_friend ORDER BY friend_of_a_friend;

friend_of_a_friend
"Bianca"
"Rosina"
In SQL si può fare lo stesso, con JOIN o query ricorsive, ma al terzo o quarto salto diventa faticoso da scrivere e da eseguire. In un database a grafo è una riga.
ACID: le promesse di una transazione
I database relazionali fanno quattro promesse, che Theo Härder e Andreas Reuter riassunsero in una sigla nel 1983:
- Atomicità: una transazione avviene tutta o per niente.
- Consistenza: porta il database solo da uno stato valido a un altro che rispetta tutte le regole.
- Isolamento: transazioni concorrenti si comportano come se fossero eseguite una dopo l’altra.
- Durabilità: una volta confermati, i dati sopravvivono a crash e blackout.
Ecco l’atomicità all’opera. Pina vuole cinque secchi di latte, ma ne restano due. L’ordine viene inserito, la riga viene inserita, poi l’aggiornamento delle scorte viola la regola CHECK:
BEGIN;
INSERT INTO orders (customer_id) VALUES (1);
INSERT INTO order_lines VALUES (2, 2, 5, 12.00);      -- 5 secchi di latte
UPDATE products SET stock = stock - 5 WHERE id = 2;   -- ma ne restano 2
ERROR:  new row for relation "products" violates check constraint "products_stock_check"
COMMIT;
ROLLBACK

SELECT count(*) AS orders FROM orders;
 orders
--------
      1
Viene annullata l’intera transazione, compreso l’ordine già inserito. Nel database c’è ancora un solo ordine, e nessun ordine a metà da ripulire a mano.
NoSQL non vuol dire automaticamente «niente transazioni»: MongoDB, per esempio, ha aggiunto le transazioni ACID su più documenti con la versione 4.0 nel 2018 (prima sui replica set, poi sui cluster distribuiti con la 4.2). Ma quanto sono forti le garanzie, e a che prezzo, cambia molto da un prodotto all’altro. Leggete la documentazione del vostro database, non quella che ricordate.
CAP: scegline due? Non proprio
Appena i dati vivono su più macchine, entra in gioco un teorema. Eric Brewer lo presentò come congettura nel 2000, e Seth Gilbert e Nancy Lynch lo dimostrarono nel 2002: un sistema distribuito non può garantire tutte e tre insieme la Consistenza (tutti vedono gli stessi dati), la Disponibilità (ogni richiesta riceve una risposta) e la tolleranza alle Partizioni (continua a funzionare quando la rete divide i nodi in gruppi che non riescono a parlarsi).
Lo si disegna spesso come un triangolo da cui «sceglierne due». Nel 2012 lo stesso Brewer spiegò che è fuorviante: le partizioni di rete capitano che vi piaccia o no, quindi la scelta vera si pone solo durante una partizione, ed è tra consistenza e disponibilità. Quando la rete funziona, si possono avere entrambe. Il PACELC di Daniel Abadi (2010) aggiunge l’altra metà: anche senza partizioni, si scambia consistenza con latenza.
Per questo Cassandra vi lascia scegliere il livello di consistenza per ogni operazione, come il CONSISTENCY QUORUM di prima: deve rispondere la maggioranza delle repliche, il che costa un po’ più di tempo ma dà più certezza.
La consistenza eventuale
Molti sistemi distribuiti scelgono la disponibilità, e accettano di essere consistenti alla fine (eventually consistent): se nessuno aggiorna più un dato, prima o poi tutte le letture restituiranno l’ultimo valore. Prima o poi. Nel frattempo, due persone possono vedere due versioni diverse. Il contrario di ACID ha perfino una sua sigla, BASE: basically available, soft state, eventually consistent.
L’esempio più famoso viene dal paper su Dynamo di Amazon (2007), ed è il carrello della spesa. I clienti devono poter aggiungere articoli al carrello «anche se i dischi si guastano, le rotte di rete vanno e vengono o i data center vengono distrutti dai tornado». Quindi, quando esistono versioni diverse di un carrello, Dynamo le unisce. Il paper è onesto sulla conseguenza: «un’operazione “aggiungi al carrello” non va mai persa. Però gli articoli cancellati possono ricomparire.»
Per un carrello, un articolo che torna dall’oltretomba è un piccolo fastidio, molto meglio di un carrello che non funziona. Per altri dati sarebbe un disastro.
Quindi, quando usare un NoSQL?
Ecco la guida pratica della mucca.
Partite da un relazionale se non avete un motivo preciso per fare altrimenti. PostgreSQL, MySQL e compagnia gestiscono relazioni, vincoli, transazioni e domande che ancora non avete pensato. E se vi servono campi flessibili, PostgreSQL ha jsonb, un tipo di colonna per documenti JSON, dalla versione 9.4 del 2014.
Passate a un NoSQL quando lo chiede un modo specifico di usare i dati:
- Chiave–valore (Redis): sessioni, cache, contatori, tutto ciò che si legge per chiave, veloce, e che può scadere.
- Documenti (MongoDB): dati con un’unità naturale che si legge e si scrive intera, con poche relazioni tra un’unità e l’altra e una struttura che cambia da un elemento all’altro.
- Colonne larghe (Cassandra): volumi enormi di scritture, distribuiti su tanti nodi o data center, letti con domande che conoscete in anticipo (serie temporali, eventi, log per dispositivo).
- Grafi (Neo4j): quando la domanda riguarda i collegamenti stessi, a molti salti di distanza (reti sociali, raccomandazioni, frodi, dipendenze).
E molto spesso la risposta è «tutti e due»: un relazionale per ordini e soldi, e accanto un chiave–valore per sessioni e cache.
Muuu. 🐄
Fonti
Tutti gli esempi di codice sono stati eseguiti su PostgreSQL 16, MongoDB 8.3, Redis 7.4, Cassandra 5.0 e Neo4j 5.26; gli output mostrati sono quelli reali.
- E. F. Codd, “A Relational Model of Data for Large Shared Data Banks”, Communications of the ACM, 1970
- Wikipedia, “NoSQL”
- Wikipedia, “ACID”
- Wikipedia, “CAP theorem”
- Wikipedia, “Eventual consistency”
- G. DeCandia et al., “Dynamo: Amazon’s Highly Available Key-value Store”, SOSP 2007
- MongoDB, multi-document ACID transactions in 4.0
- InfoQ, “MongoDB 4.0 Released” (2018)
- PostgreSQL 9.4 release notes (jsonb)
- Wikipedia, “Apache Cassandra”
- A. Lakshman, P. Malik, “Cassandra: A Decentralized Structured Storage System”