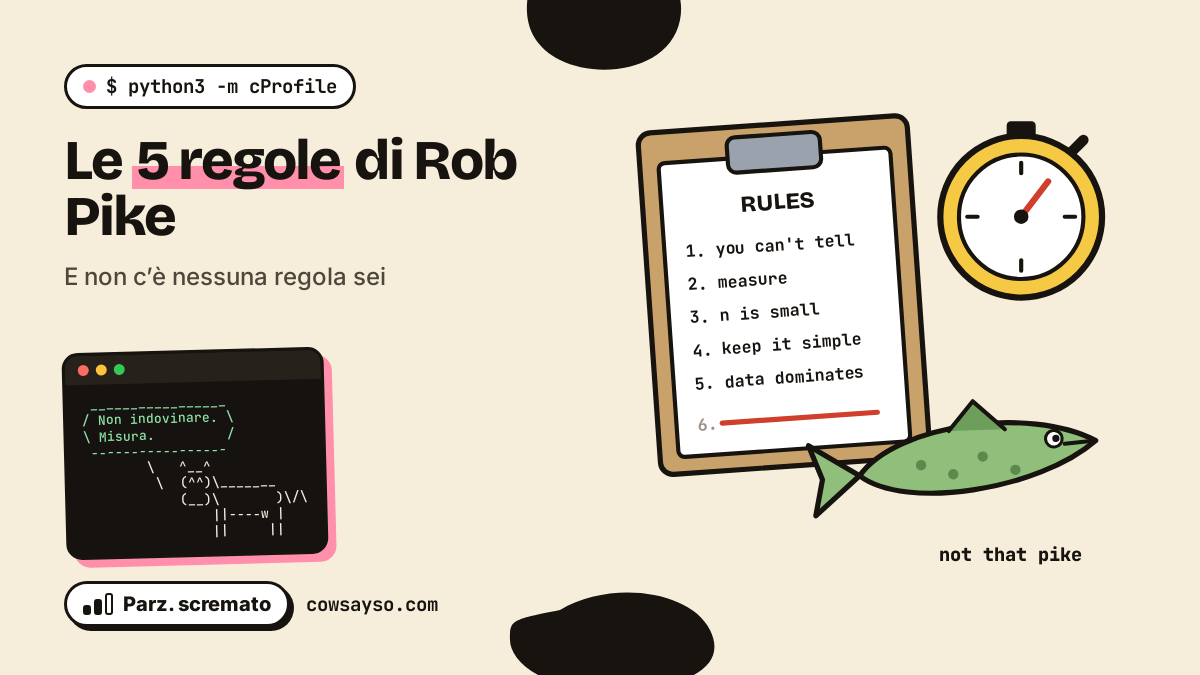
Il 21 febbraio 1989 un programmatore dei Bell Labs scrisse degli appunti su come programmare in C. Quasi tutto parla di C. Ma a metà, sotto il titolo «Complessità», ci sono cinque regole brevi che sono sopravvissute al decennio, al linguaggio e, con ogni probabilità, alla stampante su cui furono stampate la prima volta. I programmatori le citano ancora nelle code review, di solito un attimo prima di ignorarle.
Il programmatore era Rob Pike. E no, «pike» non è il luccio. Anche se il luccio è in copertina, perché la mucca ha senso dell’umorismo e nessuna vergogna.
Questo è un articolo parzialmente scremato: un po’ di codice, niente di spaventoso. Ogni esempio è stato eseguito davvero, con Python 3.13 e Go 1.25, e i numeri sono quelli veri. Il codice è in inglese, come le regole originali.
Chi è Rob Pike
Rob Pike ha lavorato ai Bell Labs nel gruppo di Unix, dove è stato tra gli artefici di Plan 9, il successore di Unix più ambizioso e meno famoso, e del terminale grafico Blit. Con Brian Kernighan ha scritto due libri classici, The Unix Programming Environment e The Practice of Programming.
Ha anche il vizio di inventare cose a cena. Per suo stesso racconto, UTF-8, la codifica che oggi permette a questa pagina di mostrare «è» e 🐄, fu progettata con Ken Thompson su una tovaglietta di carta in un diner del New Jersey, una sera intorno a settembre 1992. Quindici anni dopo, il 21 settembre 2007, lui, Thompson e Robert Griesemer cominciarono a disegnare un nuovo linguaggio su una lavagna di Google. Fu reso pubblico il 10 novembre 2009, e si chiama Go.
Quindi, quando quest’uomo scrive regole per programmatori, conviene ascoltare. Eccole, tradotte da «Notes on Programming in C»:
Regola 1. Non potete sapere dove un programma passerà il suo tempo. I colli di bottiglia compaiono in posti sorprendenti, quindi non cercate di indovinare e non infilate trucchi per la velocità finché non avete dimostrato che il collo di bottiglia è proprio lì.
Regola 2. Misurate. Non ottimizzate la velocità finché non avete misurato, e anche dopo non fatelo, a meno che una parte del codice non schiacci tutto il resto.
Regola 3. Gli algoritmi sofisticati sono lenti quando n è piccolo, e n di solito è piccolo. Gli algoritmi sofisticati hanno costanti grandi. Finché non sapete che n sarà spesso grande, non fate i sofisticati. (E anche se n diventa grande, applicate prima la regola 2.)
Regola 4. Gli algoritmi sofisticati hanno più bug di quelli semplici, e sono molto più difficili da implementare. Usate algoritmi semplici e strutture dati semplici.
Regola 5. I dati comandano. Se avete scelto le strutture dati giuste e avete organizzato bene le cose, gli algoritmi saranno quasi sempre evidenti. Al centro della programmazione ci sono le strutture dati, non gli algoritmi.
E poi, serissimo: Regola 6. Non c’è nessuna regola 6. Il che ricorda parecchio i Bruce dei Monty Python, che nel 1970 leggevano le regole della loro università australiana, compresa l’immortale «Non c’è nessuna regola sei». Pike non lo dice. Alla mucca piace pensarlo.
Regole 1 e 2: non potete saperlo, quindi misurate
Le prime due regole vanno insieme. La regola 1 dice che il vostro intuito sulle prestazioni sbaglia. La regola 2 dice cosa farci. Mettiamo alla prova la prima su noi stessi. Ecco un programmino che elabora 50.000 mungiture: per ognuna calcola una «qualità del latte» con una matematica molto scientifica e molto minacciosa (radici quadrate, logaritmi, π), e poi conta quante mucche diverse sono state munte.
import math, random

random.seed(42)
NAMES = ["Ercolina", "Pina", "Carolina", "Bianca", "Rosina", "Gelsomina"]


def milking_log(n):
    # n milkings: (cow name with a tag number, litres)
    return [(f"{random.choice(NAMES)}-{random.randrange(20000)}", random.uniform(5, 30)) for _ in range(n)]


def milk_quality(litres):
    # very scientific, very scary math
    return math.sqrt(litres) * math.log(litres + 1) / math.pi


def unique_cows(log):
    seen = []
    for name, _ in log:
        if name not in seen:
            seen.append(name)
    return seen


def report(log):
    quality = sum(milk_quality(litres) for _, litres in log)
    cows = unique_cows(log)
    return len(cows), round(quality, 1)


if __name__ == "__main__":
    print(report(milking_log(50_000)))
Prima di andare avanti: secondo voi dove passa il tempo? Nella matematica, è ovvio. Tutte quelle radici quadrate. Eseguiamolo:
$ time python3 herd.py
(40823, 190093.2)

real    0m8.301s
user    0m8.273s
sys     0m0.012s
Otto secondi per contare delle mucche. Ora, invece di tirare a indovinare, misuriamo. Python ha un profiler incluso, cProfile, che dice quanto tempo impiega ogni funzione:
$ python3 -m cProfile -s tottime herd.py
(40823, 190093.2)
         939959 function calls (939941 primitive calls) in 8.741 seconds

   Ordered by: internal time

   ncalls  tottime  percall  cumtime  percall filename:lineno(function)
        1    8.440    8.440    8.457    8.457 herd.py:17(unique_cows)
   100000    0.056    0.000    0.086    0.000 random.py:245(_randbelow_with_getrandbits)
        1    0.048    0.048    0.229    0.229 herd.py:7(milking_log)
    50000    0.030    0.000    0.083    0.000 random.py:345(choice)
    50000    0.024    0.000    0.073    0.000 random.py:295(randrange)
    50000    0.020    0.000    0.031    0.000 herd.py:12(milk_quality)
[...]
La matematica minacciosa, milk_quality, chiamata 50.000 volte: 0,03 secondi in tutto. La funzioncina innocente che conta le mucche diverse: 8,4 secondi, cioè il 97% del totale. La colpevole è una riga dall’aria inoffensiva, if name not in seen: per sapere se qualcosa è in una lista Python bisogna guardare tutti gli elementi, uno per uno. Con 40.000 mucche nella lista, è un sacco di guardare.
Ecco la regola 1 all’opera: il collo di bottiglia era nel posto su cui nessuno avrebbe scommesso. E la regola 2 è il motivo per cui l’abbiamo trovato in dieci secondi invece di passare una giornata a ottimizzare le radici quadrate.
La frase famosa che di solito si cita accanto a queste regole è «l’ottimizzazione prematura è la radice di tutti i mali». Viene da Donald Knuth, in un articolo del 1974, e spesso viene tagliata: Knuth diceva di dimenticarsi delle piccole efficienze «circa il 97% delle volte», ma di non lasciarsi sfuggire le occasioni in «quel 3% critico». La regola 2 è il modo per trovare quel 3%. (Più tardi Knuth attribuì la frase a Tony Hoare, che disse che non era sua. Anche le citazioni hanno colli di bottiglia in posti sorprendenti.)
Regola 3: n di solito è piccolo
Un algoritmo «sofisticato» vince quando i dati sono tanti, ma paga un prezzo fisso ogni volta: più preparazione, più memoria, più contabilità. Pike le chiama «costanti grandi». Con pochi dati, quel prezzo fisso è tutto quello che pagate.
Misuriamolo, in Go, che ci sembra il minimo. Cerchiamo una mucca in una mandria in due modi: scorrendo una slice dall’inizio alla fine, la cosa più stupida che possa funzionare, oppure cercandola in una map, la tabella hash di Go.
// The simple way: walk the slice.
func findSlice(herd []string, name string) bool {
	for _, c := range herd {
		if c == name {
			return true
		}
	}
	return false
}

// The "proper" way: a map (Go's hash table).
//   found := set[name]
$ go test -bench .
goos: linux
goarch: amd64
pkg: herd
cpu: Intel Core Processor (Haswell, no TSX)
BenchmarkSlice5-4 91375311 12.06 ns/op
BenchmarkMap5-4 100000000 11.56 ns/op
BenchmarkSlice1000-4 656552 1659 ns/op
BenchmarkMap1000-4 79291477 21.61 ns/op
PASSCon 5 mucche, il ciclo stupido e la tabella hash pareggiano: 12 nanosecondi contro 11,6. Tutta l’intelligenza dell’hashing non compra niente. Con 1.000 mucche, la map è circa 77 volte più veloce. Le due metà della regola 3 in una tabella: quando n è piccolo, non fate i sofisticati; quando n è grande, la struttura sofisticata si guadagna lo stipendio. E per sapere in quale caso siete, vedi regola 2.
L’esempio di Pike era più severo: «gli alberi binari sono sempre più veloci degli splay tree per i problemi di tutti i giorni». Gli splay tree, pubblicati da Sleator e Tarjan nel 1985, sono una struttura elegante con ottime garanzie teoriche. Nel 1989 erano un algoritmo sofisticato, elegante e nuovo di zecca. Il consiglio di Pike: per il lavoro di tutti i giorni vince il normale albero binario.
Regola 4: gli algoritmi sofisticati hanno più bug
Anche gli algoritmi semplici possono nascondere bug per anni. Figuriamoci quelli sofisticati. L’esempio più famoso è la ricerca binaria, l’algoritmo che ogni studente scrive al primo anno. Nel 2006 Joshua Bloch, a Google, raccontò la storia della ricerca binaria che aveva scritto per la libreria standard di Java: circa nove anni dopo il rilascio, qualcuno la trovò rotta. Il bug era in una riga che sembra perfetta:
int mid = (low + high) / 2;
Con array di più di un miliardo di elementi circa (230), low + high supera il numero più grande che un int può contenere e ricomincia dai negativi. L’abbiamo riprodotto in Go con interi a 32 bit:
package main

import "fmt"

func main() {
	var low, high int32 = 1 << 30, 1<<31 - 1 // a herd of over a billion cows
	fmt.Println("broken:", (low+high)/2)
	fmt.Println("fixed: ", low+(high-low)/2)
}
$ go run main.go
broken: -536870912
fixed: 1610612735Un punto medio negativo, cioè una lettura fuori dall’array. La stessa riga era nella ricerca binaria pubblicata in Programming Pearls di Jon Bentley, e Bentley stesso notava che, se la prima ricerca binaria fu pubblicata nel 1946, la prima che funziona correttamente per tutti i valori di n non apparve prima del 1962. Sedici anni, per un algoritmo che sta su un tovagliolo.
Ken Thompson, l’uomo che ha scritto il primo Unix, riassunse la regola 4 in poche parole: «Nel dubbio, usate la forza bruta.»
Regola 5: i dati comandano
L’ultima regola è la più profonda, e Pike ne indica la fonte: Fred Brooks, The Mythical Man-Month, pagina 102. Con le parole di Brooks: «Mostratemi i vostri diagrammi di flusso e nascondetemi le tabelle, e continuerò a non capire. Mostratemi le tabelle, e di solito non mi serviranno i diagrammi di flusso: saranno ovvi.»
La regola 5 l’abbiamo già vista all’opera. Ricordate il contatore di mucche da 8,4 secondi? La correzione non è stata un algoritmo più furbo. È stata una struttura dati diversa: un insieme (set) invece di una lista.
def unique_cows(log):
    return set(name for name, _ in log)
$ time python3 herd_set.py
(40823, 190093.2)
real 0m0.097s
user 0m0.084s
sys 0m0.012sDa 8,3 secondi a un decimo di secondo, circa 85 volte più veloce, e la funzione è diventata più corta. Con la struttura dati giusta, l’algoritmo è letteralmente una riga. È esattamente quello che promette la regola 5: scegliete bene i dati, e il codice diventa evidente.
Funziona anche per la leggibilità, non solo per la velocità. Ecco il sistema di verdetti della mucca scritto nel modo solito, come una catena di if:
def verdict(action):
    if action == "deploy on friday":
        return "wrong"
    elif action == "measure first":
        return "right"
    elif action == "splay tree for 5 cows":
        return "wrong"
    elif action == "use a hash table":
        return "it depends"
    else:
        return "the cow is thinking"
Ed eccolo con i dati al comando: una tabella, e un algoritmo che si limita a «cercare»:
VERDICTS = {
    "deploy on friday":      "wrong",
    "measure first":         "right",
    "splay tree for 5 cows": "wrong",
    "use a hash table":      "it depends",
}

def verdict(action):
    return VERDICTS.get(action, "the cow is thinking")

print(verdict("measure first"))
print(verdict("rewrite it in rust"))
$ python3 verdict_table.py
right
the cow is thinkingStesso comportamento. Ma ora aggiungere un verdetto vuol dire aggiungere una riga di dati, non un ramo di logica; potete leggere tutte le regole a colpo d’occhio, caricarle da un file o testarle in un ciclo. Pike dice anche che una manciata di strutture dati copre quasi tutti i programmi pratici: array, liste concatenate, tabelle hash e alberi binari, più le loro combinazioni.
if/else da cinquanta rami che in realtà è una tabella travestita. Sbagliato. Se il vostro codice sembra un foglio Excel, voleva essere un foglio Excel.E quindi, che ce ne facciamo?
Le cinque regole stanno in una frase: non indovinate, misurate; restate semplici finché i dati non vi danno torto; e pensate ai dati prima che al codice. Non vietano di ottimizzare, né di usare algoritmi furbi. Chiedono di farlo per un motivo che sapete dimostrare.
Trentacinque anni dopo funzionano ancora, in C, in Python, in Go e in linguaggi che quando furono scritte non esistevano. Niente male per degli appunti del 1989. Quasi tutto il codice scritto quell’anno non gira più.
Muuu. 🐄
Fonti
Gli esempi Python sono stati eseguiti con Python 3.13.5 e quelli Go con Go 1.25.14, su un server Intel Haswell a 4 core; gli output mostrati sono quelli reali. I vostri numeri saranno diversi, ed è proprio il senso della regola 2.
- Rob Pike, “Notes on Programming in C” (1989)
- Eric S. Raymond, The Art of Unix Programming, ch. 1
- Wikiquote, Fred Brooks (The Mythical Man-Month, pp. 102–3)
- Wikipedia, “Program optimization” (Knuth, 1974)
- Wikipedia, “Splay tree”
- Joshua Bloch, “Nearly All Binary Searches and Mergesorts are Broken” (2006)
- Wikipedia, “Rob Pike”
- Rob Pike, “UTF-8 history” (2003)
- The Go FAQ, project history
- Wikipedia, “Bruces sketch”